Docs as code forma parte de la documentación técnica moderna desde hace más de una década. En 2015, Riona MacNamara habló en Write the Docs sobre cómo adoptar docs as code había transformado la documentación en Google.
Y entendemos por qué se hizo tan popular.
Si diriges un equipo de ingeniería, docs as code te permite mantener la documentación cerca del código que describe.
Tus ingenieros pueden trabajar con herramientas que ya conocen, y los cambios en la documentación pueden pasar por la misma revisión de pull request, las mismas comprobaciones de integración continua (CI) y el mismo flujo de publicación que los cambios de código que describen.
Sin embargo, ese planteamiento se apoya en dos supuestos: las personas que mantienen la documentación ya trabajan en Git, y la mayoría de los cambios que la dejan desactualizada ocurren cerca del repositorio.
A medida que el equipo crece, producto y soporte acumulan más contexto, las versiones afectan a más sistemas y parte del razonamiento detrás del código nunca llega a quedar escrito en ningún sitio.
En este artículo veremos qué cambia cuando ese planteamiento se extiende más allá de tus ingenieros y del repositorio, y por qué esos cambios importan a los equipos en crecimiento que mantienen conocimiento técnico.
Conclusiones clave
- Docs as code encaja con la documentación cercana al código cuando las personas que la mantienen ya trabajan en Git.
- Un flujo de trabajo basado en Git te da historial de commits, diffs, revisión de pull requests y comprobaciones de CI para los cambios que la gente hace en la documentación. Pero no puede avisarte de una página que nadie ha tocado y que también debería haber cambiado.
- Cuando producto, soporte, redactores técnicos y otros equipos empiezan a aportar contexto técnico, una vía de contribución que solo pasa por Git deja más información útil en Slack, en tickets y en la cabeza de las personas.
- Tu repositorio conserva el conocimiento de ingeniería que la gente registra en él. Las decisiones, los compromisos, las soluciones provisionales y el contexto histórico siguen siendo tácitos hasta que alguien los pone por escrito.
- Puedes mantener docs as code para la documentación que debe estar cerca del código y, al mismo tiempo, dar al resto del equipo un espacio mantenido para el conocimiento que depende de otros sistemas y del contexto humano.
¿Qué es docs as code?
Docs as code (documentación como código) es un enfoque de la documentación técnica que utiliza herramientas y flujos de trabajo de desarrollo de software para escribir, revisar, versionar, probar y publicar documentación.
Write the Docs, una comunidad global de documentalistas, define docs as code como el uso de las mismas herramientas y procesos que los desarrolladores usan para el software, incluidos los gestores de incidencias, Git, el marcado en texto plano, la revisión de código y las pruebas automatizadas.
Un planteamiento docs-as-code típico incluye:
| Paso del flujo | Qué ocurre | Herramientas habituales |
|---|---|---|
| Redacción | La documentación se escribe como archivos fuente en texto plano. | Markdown, reStructuredText, AsciiDoc |
| Control de versiones y revisión por pares | Los cambios se confirman en una rama, se revisan como diffs y se fusionan mediante una pull request. | Git, GitHub, GitLab, Bitbucket |
| Comprobaciones de CI | Las comprobaciones automáticas validan los enlaces, el estilo, la sintaxis y la compilación de la documentación. | GitHub Actions, GitLab CI, Vale, markdownlint |
| Compilación y publicación | Un generador de sitios estáticos convierte los archivos fuente en el sitio de documentación que usan los lectores. | MkDocs, Docusaurus, Sphinx, Hugo, Jekyll |
Por ejemplo, un ingeniero que documenta una nueva funcionalidad actualiza el archivo fuente en Markdown, confirma el cambio en una rama y abre una pull request. Los revisores examinan el diff junto al cambio de código relacionado, se ejecutan las comprobaciones de CI y, cuando la pull request se fusiona, la compilación de la documentación puede publicar la página actualizada.
Por qué los equipos de ingeniería usan docs as code
Los equipos de ingeniería usan docs as code por el mismo motivo por el que usan Git para el código: le da a la documentación un historial de cambios versionado y revisable.
Para los equipos de ingeniería, hay cuatro ventajas prácticas:
- La funcionalidad y su documentación pueden publicarse en la misma pull request. Los revisores ven el cambio de código y la actualización de la documentación en el mismo contexto de revisión.
- Cada cambio en la documentación tiene un historial de commits. Los diffs, los commits, la autoría y las revisiones anteriores facilitan ver qué cambió y cuándo.
- La documentación ligada a una versión puede seguir el ritmo de esa versión. Las referencias de API, las notas de migración y la documentación de integraciones pueden avanzar al mismo ritmo que el código que describen.
- La CI se encarga de las comprobaciones mecánicas. Los linters, las comprobaciones de enlaces, las comprobaciones de estado y las compilaciones de la documentación detectan errores de formato y de compilación antes de que se publique la documentación.
Además de esas ventajas prácticas, también se suele esperar que docs as code resuelva dos problemas de documentación más grandes:
- Actualidad. Si la documentación está cerca del código, los equipos deberían tener más probabilidades de actualizarla a medida que cambia el producto.
- Menos silos de información. Si das a los colaboradores un único flujo de trabajo compartido, el conocimiento técnico debería tener menos probabilidades de perderse en herramientas separadas o en personas concretas.
Para que cualquiera de estas promesas se cumpla, alguien tiene que darse cuenta de qué documentación necesita atención, y las personas que tienen el contexto que falta necesitan una vía de contribución que de verdad vayan a usar. Como verás en las siguientes secciones, ambas promesas pueden fallar.
Cuándo docs as code es el enfoque adecuado
Hay casos en los que docs as code es justo el planteamiento que necesitas:
- Para un equipo pequeño y con mucho peso de ingeniería. Todo el mundo sigue ya el mismo repositorio, así que la documentación puede incorporarse al flujo de pull requests sin crear otro proceso que el equipo tenga que mantener.
- Para documentación de API y de referencia. Cuando cambia un endpoint, un parámetro o un SDK, la referencia suele tener que cambiar con él. Los mismos revisores suelen entender ambos lados del cambio.
- Para documentación técnica ligada a versiones. Las notas de migración, la documentación de integraciones y materiales similares se benefician de compartir el versionado y el ciclo de revisión de la versión.
Tom Johnson, redactor técnico de API en Google que antes trabajó en Amazon, sigue prefiriendo docs as code en general, pero reconoce abiertamente la fricción relacionada con Git que genera para colaboradores con distintos niveles de conocimientos técnicos.
En un artículo de 2024, sostiene que Git puede volverse difícil para equipos de redactores con perfiles técnicos diversos, incluso cuando el resto del flujo docs-as-code sigue funcionando bien.
Su argumento tiene sentido: docs as code puede seguir siendo valioso aunque Git se vuelva más difícil para algunas de las personas que deberían mantenerlo.
Así que hazte dos preguntas:
- ¿Quién mantiene realmente esta documentación?
- ¿Dónde ocurren los cambios que la dejan desactualizada?
Si ambas respuestas siguen apuntando a los ingenieros y al repositorio, docs as code está haciendo justo lo que necesitas. Sin embargo, en cuanto las respuestas empiezan a mencionar a soporte, producto, Slack, Linear, Jira, conversaciones con clientes y personas fuera de ingeniería, tienes un problema: tu sistema de documentación ha crecido más allá del repositorio.
Por qué docs as code deja de escalar en los equipos en crecimiento
No hay un número concreto de personas a partir del cual un equipo se queda pequeño para docs as code. Lo que acaba cambiando es la carga de trabajo alrededor del repositorio: más personas necesitan contribuir, más sistemas pueden cambiar lo que debería decir la documentación y más conocimiento de ingeniería se genera fuera de Git.
Así es la progresión hasta ese punto:
| Etapa | Qué empieza a resentirse |
|---|---|
| Etapa 1: cinco ingenieros, un repositorio | Muy poco. Las mismas personas ya viven en Git y suelen ser responsables tanto del código como de su explicación. |
| Etapa 2: el mismo equipo empieza a publicar más rápido | Más versiones crean más ocasiones para que las páginas existentes se queden atrás, incluidas páginas que nadie tocó en la pull request que cambió el producto. |
| Etapa 3: otros colaboradores necesitan participar | Los redactores técnicos, soporte, producto y otros equipos tienen contexto útil, pero llevarlo a la documentación ahora implica pasar por un flujo de contribución de ingeniería. |
| Etapa 4: la empresa depende de Git para documentación más amplia | Los permisos, la responsabilidad, la proliferación de repositorios, los distintos flujos de trabajo y el conocimiento generado fuera de Git convierten un flujo de documentación en un problema más amplio de mantenimiento del conocimiento. |
Cuando llegas a la etapa cuatro, mantener la documentación al día va mucho más allá de actualizar Markdown cuando cambia el código. Ahora alguien tiene que relacionar los cambios de varios sistemas con la documentación correcta y recoger el contexto de personas que quizá nunca abran el repositorio.
El control de versiones no mantiene la documentación al día
Git puede estar haciendo todo bien mientras la documentación está mal.
Durante el lanzamiento de una funcionalidad, por ejemplo, el ingeniero actualiza el código, las pruebas pasan, la CI sigue en verde, la pull request se fusiona y la compilación de la documentación funciona.
Pero el lanzamiento también cambia un paso de configuración existente que se menciona en un archivo fuente de Markdown más antiguo, y nadie toca ese archivo.
El pipeline está en verde mientras la documentación ya está obsoleta.
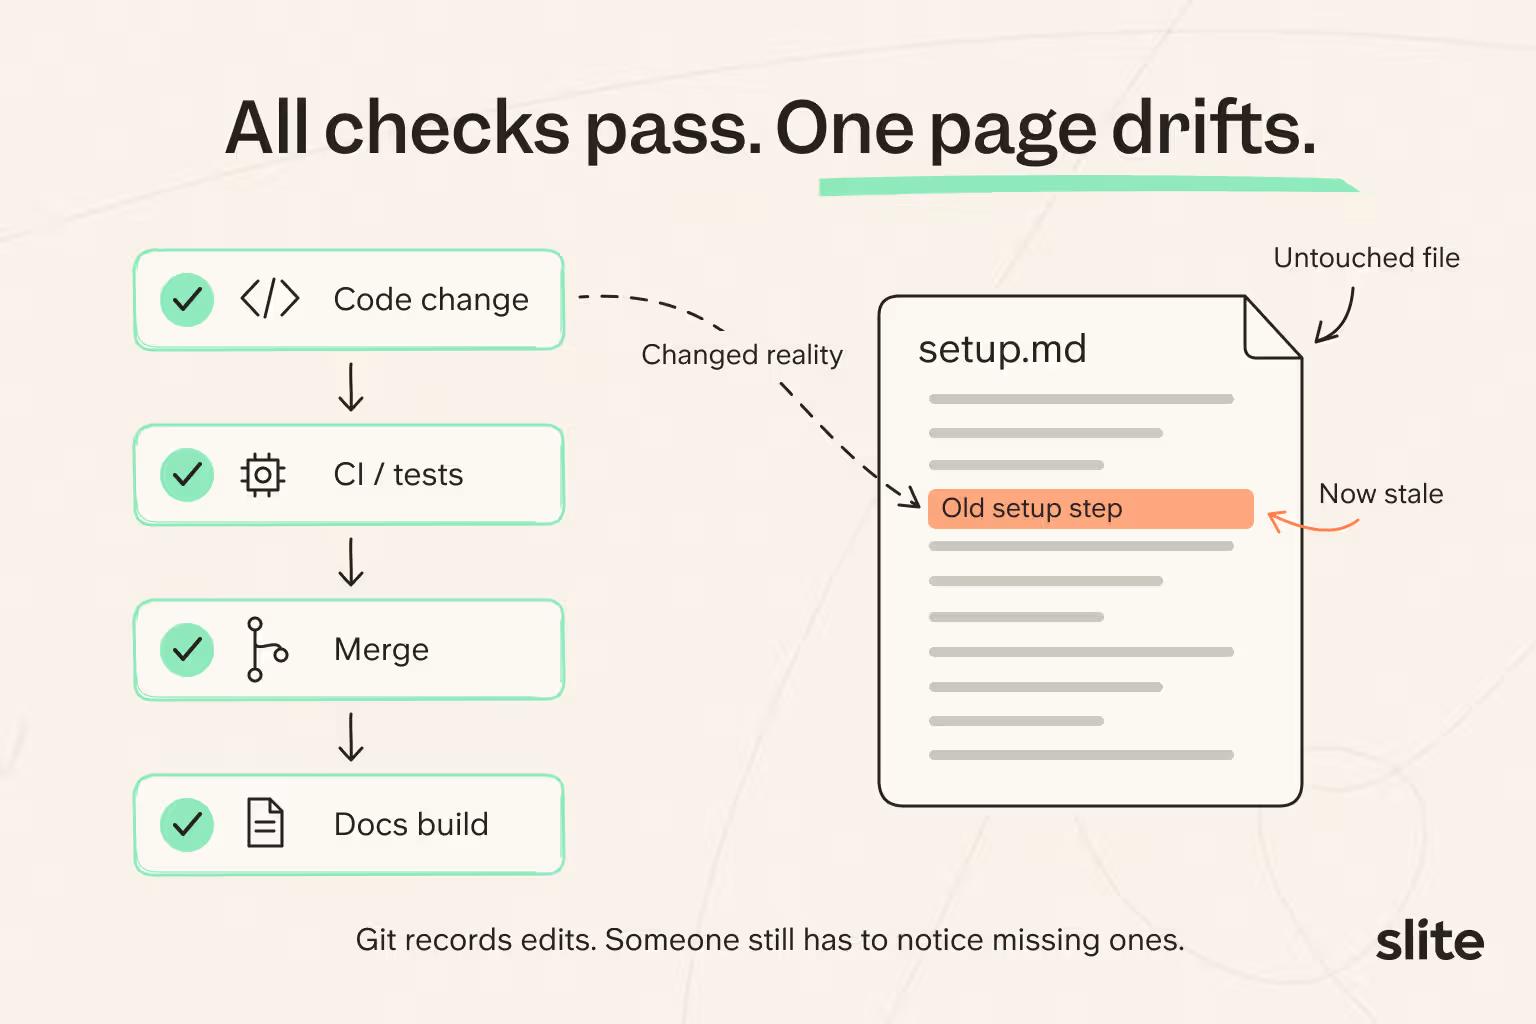
Git hizo exactamente lo que tenía que hacer. Registró los commits y los diffs de los archivos que la gente cambió. Pero no podía decirte qué documentación sin tocar también debería haber cambiado.
Oímos lo mismo de equipos que mantienen documentación en varios repositorios de GitHub. Un equipo con el que hablamos nos dijo que su documentación no dejaba de quedarse atrás respecto al ritmo de lanzamientos:
«Siempre desactualizada. Siempre. Cada semana publicamos».
Y si miras las marcas de tiempo de última modificación, resulta aún más engañoso. Una página puede editarse el lunes, un cambio de producto puede publicarse el martes y, el miércoles, tienes una marca de tiempo reciente encima de una documentación obsoleta.
En ese punto, el conocimiento se está quedando obsoleto dentro de un flujo docs-as-code bien gestionado. La página obsoleta sigue pareciendo normal para todo el mundo, lo que, por desgracia, hace que sea todavía más fácil pasarla por alto.
Cuando un compañero acaba encontrándose con una respuesta incorrecta, empieza a preguntarse qué más podría estar obsoleto. Si ese patrón se repite unas cuantas veces, el equipo empieza a preferir preguntar al ingeniero que «de verdad lo sabe», porque ya no confía en la documentación como fuente de verdad fiable.
La contribución basada en Git puede reforzar los silos de información
La contribución basada en Git funciona sin problemas cuando las personas que tienen el conocimiento ya viven en Git. En cuanto el contexto útil empieza a estar en producto, soporte, operaciones u otros equipos, el propio flujo de contribución puede convertirse en el motivo por el que esa información nunca llega a la documentación.
Para un ingeniero, abrir una pull request, trabajar en Markdown y seguir las convenciones del repositorio es algo normal. Para alguien de soporte, producto u operaciones, corregir una sola frase incorrecta puede implicar lidiar con ramas, permisos, convenciones de Markdown y revisión de código antes de que la corrección llegue a la documentación.
Johnson lo vivió en Amazon. Según cuenta, un equipo endureció su flujo de ramas en Git después de que se fusionara contenido no publicado en una rama de producción, y el proceso se volvió tan complejo que un redactor nuevo tenía miedo de hacer incluso un cambio pequeño.
Según Johnson:
«El flujo de trabajo te hacía pensártelo dos veces antes de corregir una simple errata».
Él sigue diciendo que, en general, prefiere docs as code. El flujo de trabajo tiene ventajas reales. La fricción viene de pedir a todas las personas que tienen contexto útil que adopten un flujo de trabajo de ingeniería solo para corregir la documentación.
Hemos oído preocupaciones parecidas en conversaciones con equipos de ingeniería. En una empresa, a los colaboradores sin perfil técnico les resultaba difícil actualizar GitHub, así que la documentación se quedó obsoleta y la gente pasó a hacer sus preguntas en Slack por defecto.
Imagina que alguien de soporte detecta un paso de configuración incorrecto mientras ayuda a un cliente.
Corregir la página implica pasar por una pull request; mandar «oye, este paso ha cambiado» por Slack lleva diez segundos. Gana el mensaje.
La corrección existe, pero nunca llega a la documentación. Acabas con un repositorio compartido mientras el contexto útil sigue repartido entre Slack, los tickets y las personas que saben la respuesta.
El repositorio no contiene todo lo que saben tus ingenieros
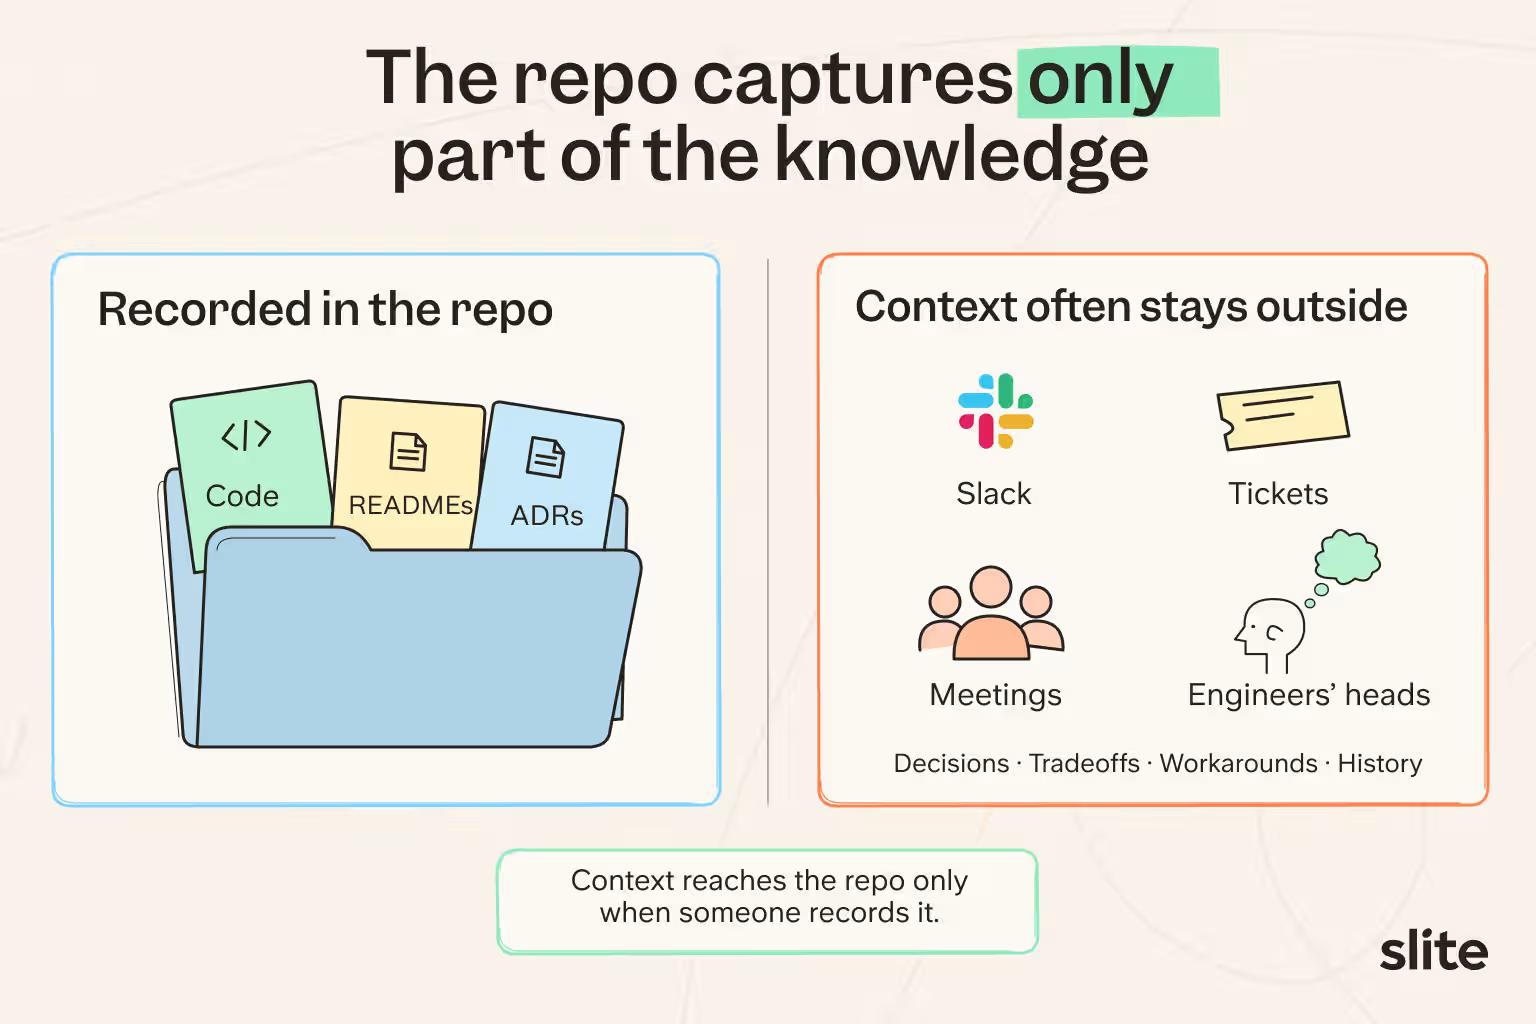
Aunque todos los colaboradores se manejen bien en Git, el repositorio solo contiene lo que la gente ha registrado de verdad.
Con el código, tienes la implementación. Los README, los registros de decisiones de arquitectura (ADR) y otros documentos del repositorio te dan explicaciones adicionales. Pero gran parte del contexto de ingeniería está en el razonamiento detrás del trabajo:
- Razonamiento arquitectónico: por qué el equipo eligió este enfoque y qué buscaba optimizar.
- Compromisos: qué alternativas se consideraron y por qué se descartaron.
- Soluciones provisionales: lo que los ingenieros con experiencia saben hacer cuando el camino documentado se queda corto.
- Contexto histórico: decisiones antiguas que explican por qué sigue existiendo una parte poco habitual del sistema.
- Contexto de incidentes y clientes: lecciones de casos de soporte, incidentes y conversaciones internas que cambiaron la forma de gestionar el sistema.
Parte de ese contexto llega a un ADR, a un ticket o a un README. Mucho se queda en hilos de Slack, en reuniones y en la cabeza de ingenieros concretos como conocimiento tribal.
Un equipo con el que hablamos calculaba que alrededor del 80 % de su conocimiento operativo seguía siendo tácito y vivía en la cabeza de las personas.
Así que un equipo en crecimiento acaba haciendo dos trabajos en paralelo:
- Mantener exacto el conocimiento ya documentado a medida que cambia el producto.
- Recoger las decisiones, las soluciones provisionales y el contexto que nunca llegaron al repositorio.
Cuando tienes que ocuparte de ambas cosas, Git ya no basta. También necesitas una capa que pueda vigilar los cambios en las herramientas que usa tu equipo y dar a las personas un lugar donde recoger el contexto que, de lo contrario, se quedaría fuera de Git.
Dale a todo el mundo una forma de contribuir a la documentación
Con Slite, personas de toda la organización pueden contribuir a la documentación sin tener que pasar por el mismo flujo de trabajo de Git.
- Alguien de soporte o de producto puede abrir el documento y hacer cambios directamente en su editor WYSIWYG.
- Los desarrolladores pueden quedarse en su herramienta o entorno de IA preferido, como Claude, ChatGPT o Cursor, y contribuir a través del MCP de Slite. El MCP también incluye llamadas a herramientas para comentarios, así que pueden iniciar, leer, responder y resolver conversaciones sin salir de ese entorno.
- Los equipos también pueden usar la API de Slite para crear y actualizar documentación de forma programática.
Plaid, por ejemplo, tenía casi 3.000 documentos internos en Markdown en Git cuando decidió reconstruir su sistema de documentación interna.
Uno de sus objetivos era sustituir el flujo de pull requests de GitHub para editar la documentación por una edición WYSIWYG.
Después de evaluar tres plataformas, Plaid eligió Slite, y todos sus usuarios piloto la prefirieron, citando su experiencia WYSIWYG intuitiva entre los motivos.
Seis meses después de la migración, el número de autores de documentación activos al mes había aumentado un 63 %, de 65 autores a 107.
Los equipos en crecimiento necesitan una capa de conocimiento que se mantenga sola por encima del repositorio
Cuando tu documentación depende de cambios en el código, tickets, conversaciones de soporte y personas de toda la empresa, necesitas algo más que Git.
Necesitas un sistema que pueda detectar cuándo cambia la realidad, relacionar esos cambios con la documentación correcta y mantener a las personas al mando del conocimiento fiable.
Así es como se hace:
1. Da a los colaboradores un único lugar donde trabajar
Con el editor WYSIWYG de Slite, ingenieros, producto, soporte, redactores técnicos y otros expertos en la materia tienen un único lugar donde añadir explicaciones, decisiones y contexto de su propio trabajo junto al resto de la documentación.
2. Conecta la documentación con los lugares donde cambia el trabajo
Los equipos de ingeniería pueden conectar fuentes como GitHub, GitLab, Jira y Linear. Slite Agent puede cruzar la base de conocimiento con la actividad en esas herramientas y usar esos cambios como señales de que un documento existente puede necesitar otra revisión.
3. Convierte esas señales en algo sobre lo que el equipo pueda actuar
Cuando Slite Agent detecta que un documento probablemente se ha quedado desactualizado, puede identificar la documentación afectada y redactar una propuesta de actualización en lugar de esperar a que alguien descubra la página obsoleta y luego la corrija.
4. Mantén a las personas al mando de la fuente de verdad
Cada propuesta de actualización pasa a Triage para revisión humana, de modo que alguien que entiende el contexto pueda aceptar, ajustar o descartar el cambio antes de que pase a formar parte de la fuente de verdad.
Tu flujo de documentación basado en Git puede seguir funcionando para la documentación que pertenece al repositorio. Slite se sitúa por encima de ese flujo como una capa de conocimiento que se mantiene sola para la información que depende de cambios en otros sistemas y del contexto de personas de toda la empresa.
En esencia, docs as code puede seguir formando parte de tu sistema de documentación. Simplemente no tiene por qué ser todo el sistema.
Si quieres ver cómo Slite mantiene el conocimiento técnico conectado con las herramientas de ingeniería que tu equipo ya usa, reserva una demo para verlo paso a paso.
Preguntas frecuentes
¿Cuáles son las buenas prácticas de docs as code?
Mantén la documentación cercana al código junto al código, actualiza la documentación directamente afectada en la misma pull request, automatiza las comprobaciones útiles y asigna responsables claros. Si hay cambios importantes que ocurren fuera del repositorio, asegúrate de que tu proceso de mantenimiento también pueda detectarlos.
¿Qué ejemplos hay de docs as code?
Algunos ejemplos habituales son la documentación de API, las guías para desarrolladores, la documentación de integraciones, las notas de migración y el material técnico de referencia escrito en Markdown u otro formato de texto plano y gestionado con Git.
¿Qué herramientas se usan para docs as code?
Entre las herramientas habituales están GitHub, GitLab o Bitbucket para alojar repositorios y revisar pull requests, Markdown o AsciiDoc para la redacción, Vale o markdownlint para las comprobaciones de CI, y Docusaurus, MkDocs o Sphinx para compilar sitios estáticos. Slite puede convivir con ese stack como la capa de conocimiento mantenida para la documentación interna que depende de cambios y contexto fuera de Git.
¿Qué papel tiene la IA en docs as code?
La IA puede ayudar a redactar documentación, detectar páginas que probablemente estén desactualizadas y marcarlas para revisión cuando cambia el producto subyacente. La revisión humana sigue siendo importante antes de que las actualizaciones propuestas por la IA se conviertan en documentación fiable.
¿Docs like code es lo mismo que docs as code?
Sí. «Docs like code» y «docs as code» suelen referirse al mismo enfoque: gestionar la documentación con Git, marcado en texto plano, revisión por pares, comprobaciones automáticas e integración continua.